Ejecución de modelos de IA localmente con Ollama
Ejecución de modelos de IA localmente con Ollama
Sección titulada «Ejecución de modelos de IA localmente con Ollama»Ollama es una herramienta que permite ejecutar modelos de lenguaje grandes (LLMs) localmente en tu máquina. Esto es especialmente útil para aquellos que desean mantener la privacidad de sus datos o reducir la dependencia de servicios en la nube. A continuación, se detalla cómo integrar Ollama con ArchiHUB para aprovechar modelos de IA localmente.
Requisitos previos
Sección titulada «Requisitos previos»El docker-compose.yml de ArchiHUB trae el servicio de Ollama comentado. Para habilitarlo, descomenta el bloque archihub_ollama:
archihub_ollama: image: ollama/ollama:latest restart: unless-stopped volumes: - ../../ollama:/root/.ollama environment: CUDA_VISIBLE_DEVICES: 0 # Remove if not using a GPU networks: - archihub_mongo_network - archihub_elastic_network command: serve # Remove the deploy section if not using a GPU deploy: resources: reservations: devices: - driver: nvidia count: 1 capabilities: [gpu]Los modelos se guardan en la carpeta ollama de la raíz del repositorio. Si la máquina no tiene una GPU NVIDIA, elimina la variable CUDA_VISIBLE_DEVICES y la sección deploy. Luego inicia el servicio con docker compose up -d.
El servicio no publica ningún puerto: el backend lo alcanza por la red interna de Docker con el nombre archihub_ollama, así que no hace falta configurar variables de entorno.
Instalación de modelos en Ollama
Sección titulada «Instalación de modelos en Ollama»Una vez que Ollama esté en funcionamiento, puedes instalar modelos de IA utilizando el comando ollama pull. Por ejemplo, para instalar el modelo llama2, ejecuta el siguiente comando en la terminal:
docker compose exec archihub_ollama ollama pull llama2 # Reemplaza "llama2" con el nombre del modelo que deseas instalar.Creación del asistente en ArchiHUB
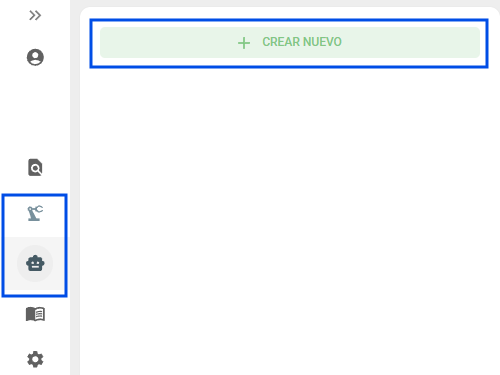
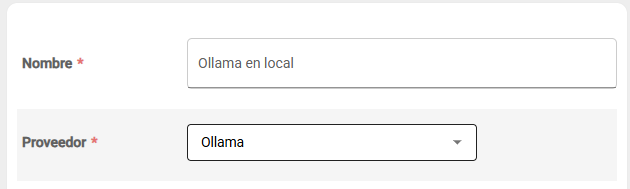
Sección titulada «Creación del asistente en ArchiHUB»Después de instalar los modelos en Ollama, ArchiHUB podrá utilizarlos para diversas tareas de inteligencia artificial. Para esto, en el menú Asistentes de IA de ArchiHUB crea un asistente nuevo con estos datos:
- Protocolo:
ollama. - URL base:
http://archihub_ollama:11434. - Modelo por defecto: uno de los modelos que instalaste, por ejemplo
llama2.
Ollama no necesita llave de acceso. Los datos del modelo, como su ventana de contexto, se consultan al propio Ollama.
Con estos pasos, habrás configurado exitosamente Ollama para ejecutar modelos de IA localmente en ArchiHUB. Ahora puedes aprovechar las capacidades de inteligencia artificial sin depender de servicios externos.
Uso de modelos en ArchiHUB
Sección titulada «Uso de modelos en ArchiHUB»Una vez que el asistente de Ollama esté configurado en ArchiHUB, podrás utilizar los modelos instalados para diversas tareas, como generación de texto, análisis de documentos, entre otros. A continuación, se presenta un listado de recursos que el asistente puede utilizar:
- Documentos cargados en ArchiHUB.
- Imágenes cargadas en ArchiHUB (si el modelo lo soporta).
- Transcripciones de audio a texto.
- Información adicional proporcionada por el usuario.
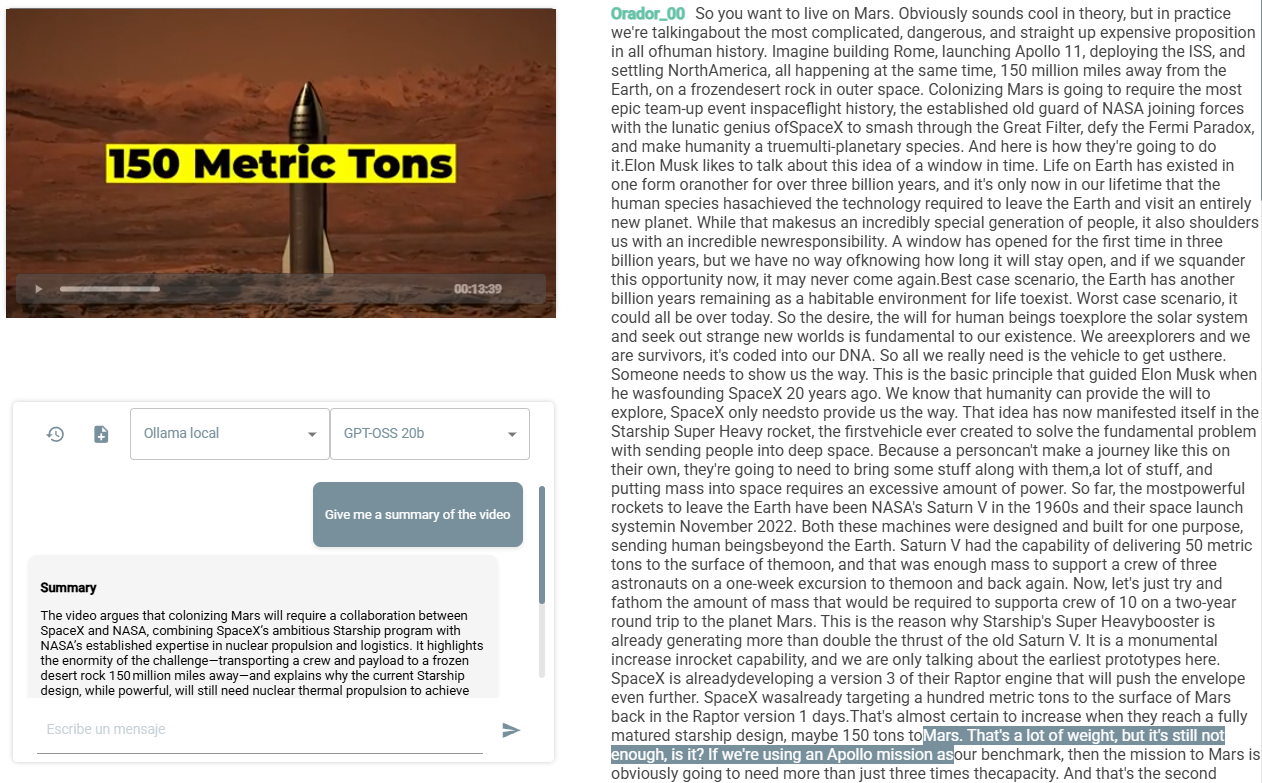
Por ejemplo, si tienes un video que se transcribió usando el plugin de transcripción, el asistente podrá analizar el texto resultante para responder preguntas o generar resúmenes basados en el contenido del video:
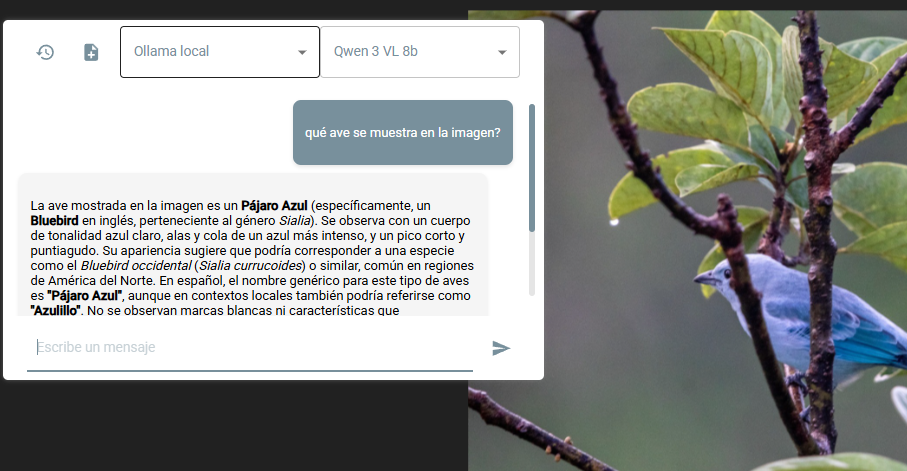
O si quieres identificar un ave a partir de una imagen cargada en ArchiHUB, el asistente podrá ayudarte a identificarla utilizando el modelo de Ollama que soporte análisis de imágenes: